Es ist kurz nach sechs, morgen früh soll die Zusammenfassung auf dem Tisch liegen: für die Runde, die über das Angebot entscheidet, oder für den Mandanten. Im Datenraum liegt ein Gutachten mit mehreren hundert Seiten. Der schnellste Weg ist einen Browser-Tab entfernt: der private KI-Zugang, mit dem man am Wochenende auch die Urlaubsreise plant. Kopieren, einfügen, Zusammenfassung da. Im Haus weiß das niemand, und erfahren es die eigenen Kunden, wird es unangenehm. Denn gerade von dort kommt der Druck, vertrauliche Unterlagen sauber zu behandeln.
Das sind keine nachlässigen Leute, sondern gute Leute unter Zeitdruck. Das Problem ist nicht die KI, sondern wo sie läuft und wer davon weiß.
Auf einen Blick
- 48 Prozent der Beschäftigten, die KI im Job nutzen, haben laut KPMG und Universität Melbourne sensible Firmendaten in öffentliche KI-Werkzeuge geladen. Wo KI verboten ist, sind es 67 Prozent.
- 34,6 Prozent der Führungskräfte in Deutschland, die KI beruflich nutzen, greifen laut IW zu Werkzeugen, die der Arbeitgeber nicht bereitgestellt hat. Über alle Beschäftigten sind es 29,1 Prozent.
- Jede fünfte von 600 Organisationen mit Datenpanne meldete laut IBM einen Vorfall durch Schatten-KI. Mit viel Schatten-KI kostete eine Panne im Schnitt 670.000 US-Dollar mehr.
- Auch Firmentarife direkt beim Hersteller bieten Datenhaltung in Europa nur in bestimmten Tarifen, oder sie speichern laut eigener Angabe in den USA.
- In AIMI arbeitet Ihr Team mit Claude Opus 5.5, GPT-6 Astra und Gemini 4 Argon, alle in der EU gehostet und ohne Training mit Ihren Daten.
Was die Zahlen sagen
Schatten-KI heißt: Beschäftigte nutzen KI-Werkzeuge, die ihr Arbeitgeber nicht bereitgestellt hat. Das ist kein Randphänomen, und es betrifft nicht nur die Sachbearbeitung.
- Fast jeder Zweite gibt Firmendaten ein. In der weltweiten Studie von KPMG und der Universität Melbourne mit 48.340 Befragten in 47 Ländern berichten 48 Prozent der Beschäftigten, die KI bei der Arbeit nutzen, dass sie sensible Firmeninformationen wie Finanz-, Vertriebs- oder Kundendaten in öffentliche KI-Werkzeuge hochgeladen haben. 56 Prozent haben KI genutzt, ohne zu wissen, ob es erlaubt ist. 57 Prozent räumen ein, KI verdeckt genutzt zu haben, etwa indem sie Ergebnisse der KI als eigene ausgaben oder verschwiegen, dass sie KI verwendet haben.
- In Deutschland nutzt fast jeder Dritte eigene Werkzeuge, in der Führungsetage noch mehr. Laut einer repräsentativen Befragung des Instituts der deutschen Wirtschaft unter knapp 5.000 Beschäftigten vom Frühjahr 2026 verwenden 29,1 Prozent der beruflichen KI-Nutzer Werkzeuge, die der Arbeitgeber nicht bereitgestellt hat. Bei Führungskräften sind es 34,6 Prozent, bei Beschäftigten ohne Führungsverantwortung 25,6 Prozent. In kleinen Unternehmen unter 50 Beschäftigten liegt der Anteil bei 33,5 Prozent, in Unternehmen ab 250 Beschäftigten bei 25,5 Prozent. Die großen stellen nach dem IW häufiger selbst KI-Werkzeuge bereit. Das IW betont: Nicht bereitgestellt heißt nicht zwingend heimlich, wohl aber außerhalb der betrieblichen Kontrolle.
- Die Unternehmen ahnen es, und nur wenige haben Regeln. Nach einer Umfrage des Bitkom unter 604 Unternehmen gehen 4 von 10 zumindest davon aus, dass ihre Beschäftigten private KI-Werkzeuge einsetzen. In 8 Prozent ist es weit verbreitet, doppelt so oft wie ein Jahr zuvor. Regeln für den Einsatz von KI hat nur knapp ein Viertel aufgestellt (23 Prozent), und 26 Prozent stellen ihren Beschäftigten selbst Zugang zu generativer KI bereit.
- Es fließen echte Daten ab, und es wird teuer. Der Cost of a Data Breach Report 2025 von IBM wertet die Datenpannen von 600 Organisationen aus. Eine Datenpanne kostete dort im weltweiten Schnitt 4,44 Millionen US-Dollar. Jede fünfte Organisation meldete einen Vorfall durch Schatten-KI. Wo viel Schatten-KI im Spiel war, kostete eine Panne im Schnitt 670.000 US-Dollar mehr als dort, wo wenig oder keine im Spiel war. Bei Vorfällen mit Schatten-KI waren häufiger personenbezogene Daten betroffen (65 Prozent gegenüber 53 Prozent im Schnitt aller Pannen), ebenso geistiges Eigentum (40 gegenüber 33 Prozent). Und 63 Prozent der betroffenen Organisationen hatten keine Richtlinie für den Umgang mit KI oder arbeiteten noch daran.
- Es passiert laufend. Der Sicherheitsanbieter Cyberhaven hat die KI-Nutzung in 222 Kundenunternehmen technisch gemessen: 39,7 Prozent aller Interaktionen mit KI-Werkzeugen, ob freigegeben oder nicht, enthielten Daten, die als sensibel markiert waren. Im Schnitt gibt damit ein Beschäftigter alle drei Tage sensible Daten in ein KI-Werkzeug ein. Ein Drittel der Beschäftigten greift über private Konten auf generative KI zu.
Die Studien messen Verschiedenes, mal Selbstauskunft, mal Einschätzung der Firma, mal technische Messung. Die Richtung ist bei allen dieselbe.
Warum Verbote nicht helfen
Der naheliegende Reflex ist ein Verbot. Die Studie von KPMG und der Universität Melbourne zeigt, warum das selten trägt: Dort, wo generative KI verboten ist, berichten 67 Prozent der Beschäftigten, sensible Firmendaten in öffentliche Werkzeuge geladen zu haben. Ohne jede Regel sind es 33 Prozent. Die Autoren halten Verbote für wenig wirksam. Auch eine bloße Richtlinie sichere die Einhaltung nicht (dort 56 Prozent), nötig seien klare Anleitung und Schulung.
In dieselbe Richtung geht, mit Blick auf den Datenschutz, die Orientierungshilfe der deutschen Datenschutzaufsichtsbehörden (DSK) vom Mai 2024. Ohne klare Regeln bestehe das Risiko, dass Beschäftigte KI eigenmächtig und unkontrolliert nutzen. Ihre Empfehlung: Arbeitgeber sollten Geräte und Konten für die berufliche KI-Nutzung bereitstellen, damit niemand mit privaten Konten arbeiten muss. Vorzugswürdig seien Anwendungen, die Ein- und Ausgaben nicht zum Training verwenden.
Gibt das Haus das beste Werkzeug nicht her, sucht man es sich selbst. Verständlich, aber nicht abgesichert.
Was auf dem Spiel steht, wenn es um Datenraum und Mandat geht
In Transaktionen ist Vertraulichkeit keine Kür. Vor dem Zugang zum Datenraum steht üblicherweise eine Vertraulichkeitsvereinbarung, die regelt, wer die Unterlagen sehen darf und wofür. Ein privater KI-Zugang ist dort nicht vorgesehen. Das gilt für Käufer genauso wie für Ingenieur- und Beratungshäuser. Wer Unterlagen des Verkäufers in ein privates Konto kopiert, kann die Vereinbarung berühren und damit das Vertrauen, auf dem der Prozess steht. Dazu kommen gesetzliche Pflichten, je nach Rolle:
- Berufsgeheimnis: § 203 StGB stellt das unbefugte Offenbaren anvertrauter Geheimnisse, ausdrücklich auch Betriebs- und Geschäftsgeheimnisse, für Rechtsanwälte, Wirtschaftsprüfer und Steuerberater unter Strafe. Dienstleister dürfen nur eingebunden werden, soweit es erforderlich ist, und müssen zur Geheimhaltung verpflichtet sein.
- Anwaltliches Berufsrecht: Nach § 43e BRAO braucht der Einsatz eines Dienstleisters mit Zugang zu Mandatsgeheimnissen einen Vertrag in Textform mit Verschwiegenheitspflicht. Wird die Leistung im Ausland erbracht, muss der Geheimnisschutz dort vergleichbar sein. Dient sie unmittelbar einem einzelnen Mandat, braucht es zusätzlich die Einwilligung des Mandanten.
- Datenschutz: Lässt ein Unternehmen personenbezogene Daten im Auftrag verarbeiten, braucht es nach Art. 28 DSGVO einen Vertrag. Übermittlungen in Drittländer sind nach Art. 44 DSGVO nur unter den Bedingungen der Verordnung zulässig. Und jede Verarbeitung braucht eine Rechtsgrundlage, auch die Eingabe in einen KI-Dienst.
- Geschäftsgeheimnisse: Das Geschäftsgeheimnisgesetz schützt eine Information nur, wenn ihr Inhaber angemessene Geheimhaltungsmaßnahmen getroffen hat. Die Vertraulichkeitsvereinbarung zum Datenraum ist eine solche Maßnahme. Sie bindet jeden, der unterschrieben hat, auch ohne Berufsgeheimnis.
Ob ein einzelner Fall gegen eine dieser Pflichten verstößt, ist eine Frage des Einzelfalls und keine, die ein Blogbeitrag beantwortet. Klar ist aber: Ein privater Zugang ohne Vertrag mit dem Haus lässt sich gegenüber Mandant, Verkäufer oder Aufsicht schwer erklären.
Und die Firmenlizenz direkt beim Hersteller?
Der nächste Gedanke liegt nahe: Dann kaufen wir eben die Team- oder Business-Lizenz direkt beim Hersteller. Das ist ein echter Fortschritt gegenüber dem privaten Konto, denn dort gibt es einen Vertrag mit dem Haus, und die großen Hersteller trainieren nach eigener Aussage mit Firmendaten nicht standardmäßig. Die Frage, wo die Daten liegen, ist damit aber noch nicht beantwortet. Ein Blick auf die Seiten der Hersteller selbst, Stand 5. November 2026:
- Beim Hersteller von GPT verwendet der Anbieter Daten aus seinen Business-, Enterprise- und Edu-Tarifen und aus der API nach eigener Aussage standardmäßig nicht zum Training. Die Speicherung in Europa können laut seiner Hilfeseite zur Datenhaltung aber nur berechtigte API-Kunden und neue Enterprise- und Edu-Kunden wählen. Der Business-Tarif für kleinere Teams ist dort nicht genannt.
- Beim Hersteller von Claude heißt es für die gewerblichen Angebote, Anfragen könnten standardmäßig über Länder in den USA, Europa, Asien und Australien geleitet werden, und weiter: Die Daten werden in den USA gespeichert. So steht es auf seiner Datenschutzseite vom 15. Juni 2026.
Ob ein solcher Tarif für Ihr Haus reicht, hängt vom Vertrag, von den Daten und von Ihren Pflichten ab. Das beurteilen Ihre IT und Ihr Datenschutz, nicht wir. Gleichgültig ist der Ort aber nicht: Für Anwälte verlangt § 43e BRAO bei Leistungen im Ausland einen vergleichbaren Geheimnisschutz, und für personenbezogene Daten knüpft die DSGVO jede Übermittlung in ein Drittland an eigene Bedingungen. Wer die Speicherung in Europa braucht, landet nach diesen Seiten beim einen Hersteller im großen Tarif und beim anderen bei der Speicherung in den USA. Und jeder dieser Verträge gilt für genau einen Hersteller.
Ein privater Zugang soll keinen Vorteil mehr bringen
Die Antwort ist deshalb nicht weniger KI, sondern die richtige. Wir arbeiten mit AIMI hart daran, dass ein privater Zugang keinen Vorteil mehr bringt. Dafür sorgen drei Dinge.
Erstens die Modelle. In AIMI stecken die Flaggschiffe von Claude, GPT und Gemini, in einer Plattform statt in drei Verträgen:
- Claude Opus 5.5, dazu Sonnet 5.5 und Haiku 5.5
- GPT-6 Astra, dazu die Varianten Sol, Terra und Luna
- Gemini 4 Argon, dazu Gemini 3.8 Flash und 3.5 Flash
- Auto: Wer nicht wählen will, lässt AIMI je Anfrage das passende Modell aus dieser Liste nehmen, die großen für schwierige Fragen, die kleineren für schnelle Antworten
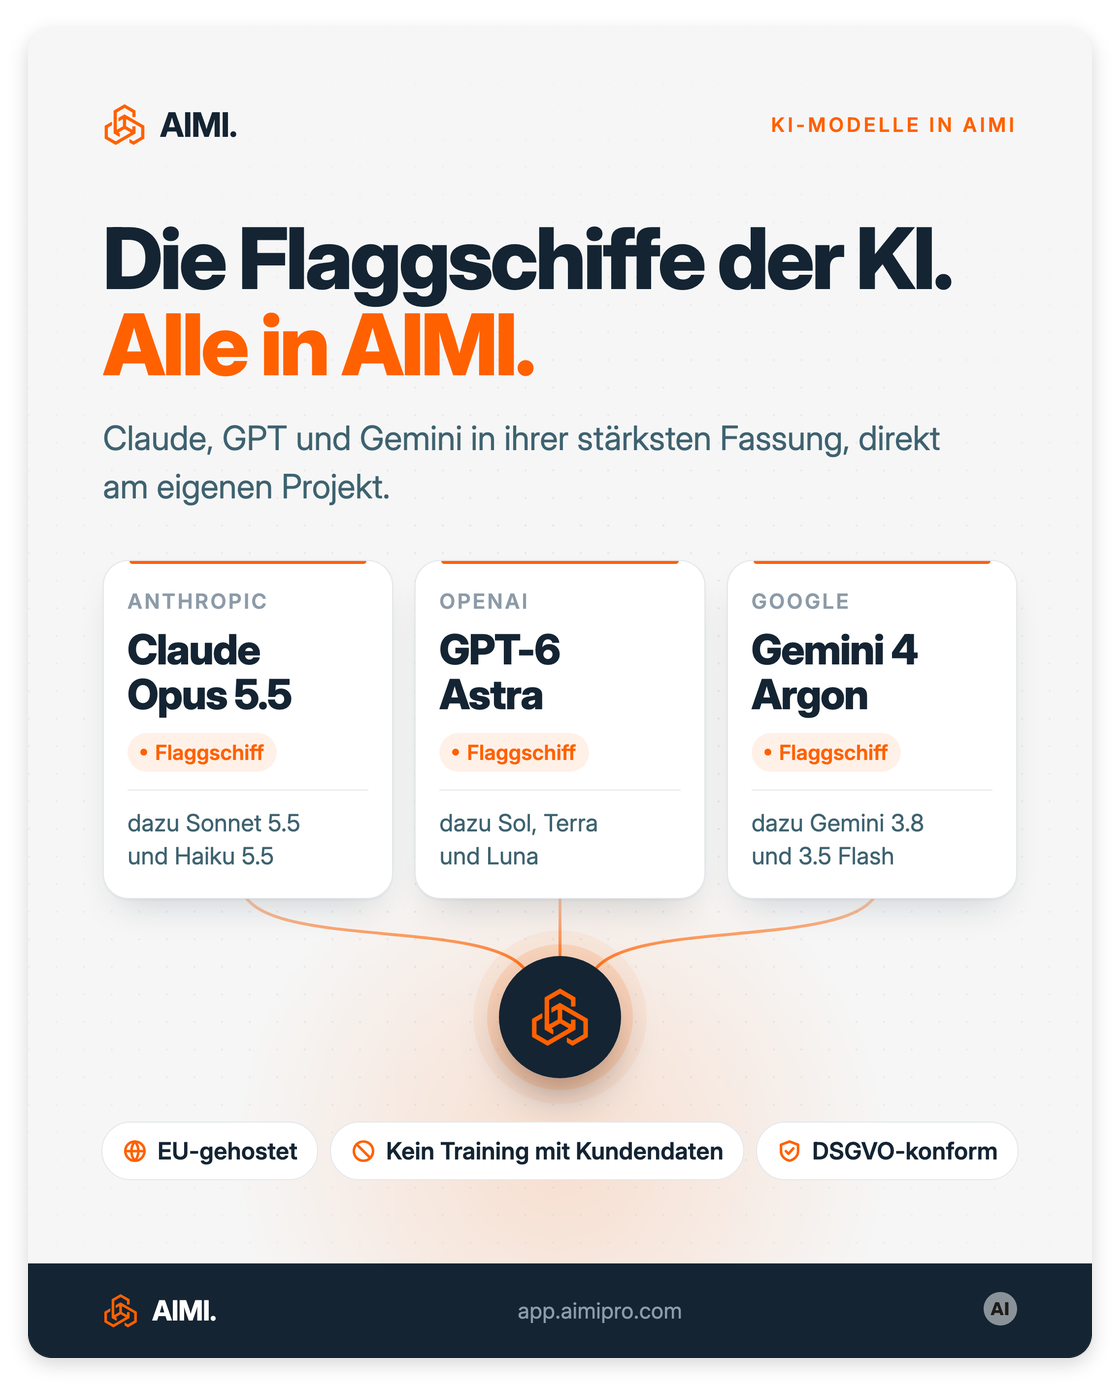
Alle Modelle sind in der EU gehostet, Ihre Daten werden nicht zum Training verwendet, und die Verarbeitung ist DSGVO-konform. Dafür gilt eine einfache Regel: Was das nicht sauber einhält, kommt nicht rein. Claude Fable zum Beispiel gibt es nur, wenn alle Anfragen 30 Tage gespeichert werden, so schreibt es der Hersteller selbst. Deshalb bieten wir es bewusst nicht an.
Zweitens die Fähigkeiten. Wir holen nicht blind alles herein, was die Apps der KI-Anbieter neu können. Wir übernehmen, was Ihrem Team in der Arbeit wirklich hilft, und lassen den Rest weg. In den letzten Wochen kam dazu: Jede Antwort lässt sich als Grafik oder Dokument speichern und mit Kollegen teilen, und eigene Agenten arbeiten wiederkehrende Abläufe selbstständig ab, bis zur fertigen Word-, PowerPoint- oder Excel-Datei.
Vieles schneiden wir dabei auf Ihr Haus zu: Ihre Vorlagen, Ihre Abläufe, Ihre Begriffe. Ein Werkzeug, das für Millionen Nutzer gebaut wird, richtet sich selten nach den Wünschen eines einzelnen Hauses. Wir sind nah an unseren Kunden. Fehlt Ihrem Team etwas, hören wir zu und machen die Plattform gemeinsam mit Ihnen besser.
Drittens Ihr Projektwissen. Das hat kein privater Zugang, und dort sollte es auch besser nicht gespeichert werden. Schon mal dreitausend Seiten von einem Chatbot auslesen lassen? Das macht wenig Spaß. Man kopiert Dokument für Dokument hinein, wartet, kopiert weiter und muss selbst den Überblick behalten, was schon drin war und was noch fehlt. In AIMI fragt Ihr Team das ganze Projekt: alle Dokumente im Datenraum, nicht nur das eine, das gerade im Fenster liegt. Das Urteil bleibt bei Ihnen. Und Ihre Daten bleiben Ihre, in Europa, getrennt von jedem anderen Haus.
Eine Grenze nennen wir offen: Was Ihre Beschäftigten außerhalb von AIMI tun, können wir nicht steuern. Wir können nur dafür sorgen, dass es keinen Grund mehr gibt, auszuweichen.
Was als Nächstes kommt
Dass sich mit dem richtigen Modell auch die Kosten bewegen, zeigt gerade eine Bank: Revolut hat rund 2.000 Entwickler auf ein offenes Modell umgestellt, das die Bank selbst betreibt, nach eigener Aussage für etwa ein Zehntel der bisherigen Rechnung, Kosten für Cloud, Personal und Überwachung nicht eingerechnet. Wir arbeiten in ersten Piloten an etwas Ähnlichem, mit europäischen und offenen Modellen, gehostet in der EU und günstiger. Das kommt bald für eine kleine Gruppe von Kunden.
Quellen
- KPMG und University of Melbourne: Trust, attitudes and use of artificial intelligence. A global study 2025
- Institut der deutschen Wirtschaft: Schatten-KI. Beschäftigte sind schneller als ihre Betriebe (IW-Kurzbericht 63/2026)
- Bitkom: Beschäftigte nutzen Schatten-KI (Presseinformation, 21.10.2025)
- IBM: Cost of a Data Breach Report 2025 (Pressemitteilung, 30.07.2025)
- Cyberhaven Labs: AI Risk Report 2026
- Datenschutzkonferenz: Orientierungshilfe Künstliche Intelligenz und Datenschutz, Version 1.0 (06.05.2024)
- § 203 StGB: Verletzung von Privatgeheimnissen
- § 43e BRAO: Inanspruchnahme von Dienstleistungen
- Verordnung (EU) 2016/679, Datenschutz-Grundverordnung
- § 2 GeschGehG: Begriffsbestimmungen
- Hersteller von GPT: Business data privacy, security, and compliance (abgerufen 05.11.2026)
- Hersteller von GPT, Hilfe: Data residency and inference residency for ChatGPT (abgerufen 05.11.2026)
- Hersteller von Claude, Datenschutz: Where are your servers located? (15.06.2026, abgerufen 05.11.2026)
- Claude Platform Docs: API and data retention
- Trending Topics: Revolut stellt 2.000 Entwickler auf ein offenes Modell um (03.11.2026)